
Si votre équipe croule sous les alertes et ne sait toujours pas ce qui nécessite une action immédiate, la solution n'est pas d'ajouter des tableaux de bord. Il s'agit plutôt d'un processus de triage des incidents plus rigoureux, qui valide le signal, ajoute le contexte métier, attribue clairement les responsabilités et permet de contenir rapidement les menaces réelles.135
Un processus de triage des incidents bien rodé transforme les alertes intempestives en actions structurées. Il standardise la manière dont votre équipe classe les alertes, confirme leur authenticité, protège en priorité les systèmes critiques et ne confie à une équipe que les tâches nécessitant une investigation approfondie. C'est essentiel, car la réponse aux incidents est désormais un élément central de la gestion des risques de cybersécurité, et non plus une procédure annexe improvisée sous pression.12

Vous avez besoin d'un processus de triage que votre équipe puisse réellement appliquer sous pression ?
MSP Corp aide les entreprises à standardiser leurs opérations de sécurité grâce à des services de cybersécurité gérés, une expertise Microsoft Sentinel et une surveillance continue (24 h/24 et 7 j/7) qui priorise les actions les plus critiques. Si vos alertes vous semblent intempestives, réactives ou difficiles à exploiter, nous pouvons vous aider à mettre en place un processus permettant de transformer les signaux d'alerte en actions correctives.
Qu’est-ce qu’un processus de triage des incidents, et qu’est-ce qu’il n’est pas ?
An flux de travail de triage des incidents Il s'agit du processus reproductible allant du premier signal à l'action confirmée. Il indique à votre équipe comment recevoir les alertes, les contextualiser, déterminer si l'événement est bénin ou suspect, évaluer son impact sur l'activité, désigner un responsable, déclencher le confinement et transmettre le dossier aux équipes d'enquête, de rétablissement et d'analyse des enseignements tirés.12
Il ne s'agit pas d'une vague consigne du type « on verra plus tard », ni d'une file d'attente remplie de détections non traitées. Un tri rigoureux est mis en place pour protéger en priorité les systèmes critiques de l'entreprise. Le Centre canadien pour la cybersécurité recommande d'identifier les systèmes et les informations sensibles avant d'élaborer le plan, tandis que les recommandations de la CISA en matière de ransomware insistent sur la nécessité de restaurer les systèmes en se basant sur une liste prédéfinie d'actifs critiques, plutôt que de procéder par conjectures sous la pression.28
| Type de signal | Ce que cela veut dire | Propriétaire typique | Rendement souhaité |
|---|---|---|---|
| Alerte | Un signal généré par un outil qui peut ou non refléter une activité malveillante réelle. | SIEM, EDR, sécurité du courrier électronique, plateforme d'identité | Enrichissement, validation et disposition |
| Incident | Un événement confirmé ou à forte probabilité nécessitant une réponse coordonnée et une gestion appropriée des preuves. | Analyste de sécurité, responsable informatique, commandant d'incident | Confinement, enquête, communication, rétablissement |
| Billet ou tâche | L'élément de travail opérationnel qui garantit la mise en œuvre effective d'une action de réponse. | Opérations informatiques, opérations de sécurité, intervenant tiers | Suivi des mesures correctives, de la propriété et de la date d'échéance |
plats à emporter clés: Ne laissez pas chaque alerte se transformer en contravention, et ne laissez pas chaque contravention se faire passer pour un incident.
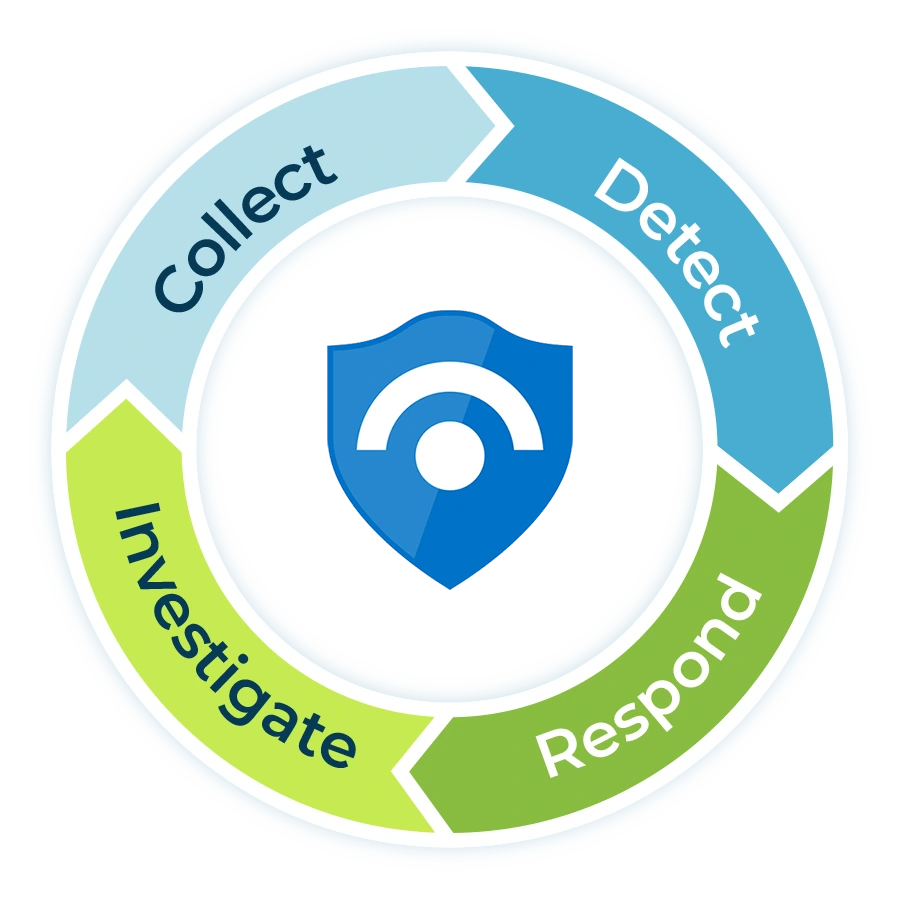
Un processus pratique de triage des incidents, étape par étape
Le flux de travail ci-dessous est conçu pour les PME et les entreprises de taille intermédiaire canadiennes où les ressources informatiques internes sont réduites, la responsabilité de la sécurité est partagée et la qualité des interventions repose sur des transitions rigoureuses. Il s'intègre parfaitement aux solutions SIEM et SOAR modernes telles que Microsoft Sentinel, où les règles d'automatisation, les tâches d'incident et les playbooks contribuent à standardiser les processus.91011
Ingérer et normaliser le signal
Commencez par centraliser les alertes dans une file d'attente unique avec des champs uniformes : source, horodatage, entité, ressource, utilisateur, gravité, tactique MITRE, environnement et métadonnées d'identité ou de point de terminaison associées. Le triage devient impossible lorsque chaque outil décrit le risque différemment.
C’est là que la corrélation prend toute son importance. Les alertes en double, les détections liées et les événements répétés provenant d’un même hôte ou d’une même identité doivent être regroupés afin que les analystes ne perdent pas de temps à enquêter trois fois sur le même problème.
Enrichissez le contexte commercial avant de classifier
Le contexte est essentiel pour transformer une détection brute en une véritable décision de triage. Il faut également prendre en compte la criticité de l'actif, le responsable métier, la situation géographique, le rôle de l'utilisateur, la sécurité de l'appareil, son exposition à Internet, l'historique des incidents ouverts et si l'utilisateur ou le système gère des revenus, des données réglementées ou les opérations clients.
Utilisez cette étape pour vérifier si l'alerte concerne des systèmes déjà documentés dans votre documentation. plan d'intervention écrit en cas d'incident, tout Les responsables de la continuité des activités et de la repriseou des lacunes connues issues d'examens de risques antérieurs.
Déterminez si l'affirmation est vraie, fausse ou si elle nécessite davantage de preuves.
Votre objectif n'est pas de prouver la malveillance de chaque alerte. Il s'agit plutôt de déterminer sa nature, son impact et les actions à entreprendre. Utilisez des vérifications de validation rapides : déplacement impossible et connexion réussie ; déplacement impossible et échec de l'authentification multifacteur ; exécution sur un terminal et comportement d'un processus enfant ; clic sur un e-mail et réutilisation d'un jeton ; blocage par pare-feu et tentatives répétées de déplacement latéral, etc.
En l'absence de preuves suffisantes, classer l'événement comme nécessite davantage de preuves et définissez une courte tâche de suivi. Cela permet de maintenir la file d'attente à jour sans fermer prématurément une tâche importante.
Attribuer la gravité en fonction de l'impact d'abord, puis de la confiance.
La confiance excessive sans impact conduit à une réaction disproportionnée. L'impact sans confiance engendre la paralysie. Un bon modèle de gravité établit un équilibre entre les deux. Par exemple, la détection d'une menace avec un niveau de confiance moyen sur une identité privilégiée liée à des systèmes sensibles peut justifier une intervention plus rapide que la détection d'un logiciel malveillant avec un niveau de confiance élevé, isolé à une borne interactive sans incidence sur l'activité.
C’est également dans ce contexte que les tendances connues en matière de menaces devraient inciter à la vigilance. L’étude DBIR 2025 de Verizon a révélé que l’exploitation des vulnérabilités continuait de progresser, notamment autour des périphériques et des VPN, ce qui signifie que les infrastructures exposées à Internet et les alertes d’accès à distance méritent une attention accrue par rapport à celle que leur accordent encore de nombreuses équipes.5
Déclencher le confinement dès que le seuil est atteint
Le confinement doit débuter dès que le seuil de réponse est atteint, et non une fois l'enquête terminée. Désactivez les sessions à risque, isolez les hôtes, bloquez les expéditeurs, révoquez les jetons d'accès, exigez une réinitialisation des mots de passe, désactivez l'accès VPN ou limitez les déplacements latéraux. La CISA recommande notamment d'identifier les systèmes et comptes concernés par la violation, de préserver les preuves pertinentes et de restaurer les données à partir de sauvegardes chiffrées hors ligne, en fonction de leur criticité, dès le début de la récupération.8
Les événements liés à l'identité et à l'accès apparaissent souvent ici. Lorsque des connexions à risque parviennent à contourner les contrôles de base, les équipes ont généralement besoin de politiques d'accès conditionnel et de renforcement plus strictes, et non d'une simple case à cocher pour l'authentification multifacteur. C'est pourquoi il est utile d'aligner le triage sur un travail plus global de renforcement de la sécurité des accès, tel que : Ajouter l'accès conditionnel correctement et améliorer votre posture d'accès à distance au-delà de la dépendance traditionnelle au VPN.
Transférer l'incident confirmé vers une enquête et une action coordonnée.
Une fois un événement confirmé, la phase de triage doit fournir un dossier complet : résumé de l’incident, entités concernées, hypothèse de travail, chronologie initiale, mesures de confinement prises, risques résiduels, localisation des preuves et, le cas échéant, analyse d’impact à destination de la direction. C’est à ce stade qu’une plateforme SIEM et SOAR doit automatiquement créer des tâches, désigner des responsables et exécuter des procédures validées afin de garantir la cohérence des processus.91011
Pour les incidents d'infrastructure, les procédures d'exploitation documentées sont tout aussi importantes que les détections. manuels de réponse spécifiques au service En cas de panne ou de défaillance de la plateforme, il convient d'utiliser des modifications réseau contrôlées pour limiter les risques sans provoquer d'interruption de service. Si des modifications du pare-feu font partie du confinement, votre équipe devrait déjà savoir comment procéder. Examiner les règles du pare-feu sans perturber les applications professionnelles.
Récupérer les enseignements, les documenter et les réintégrer dans le système de détection.
Le triage n'est pas terminé lorsque l'élément de la file d'attente est fermé. La récupération doit rétablir la connexion sécurisée des systèmes opérationnels, confirmer la restauration des contrôles, documenter les défaillances et intégrer les enseignements tirés dans les analyses, les procédures opérationnelles standard, les audits de pare-feu, la politique de sécurité des terminaux et la validation des sauvegardes.8
C’est grâce à cette boucle de rétroaction que le flux de travail s’améliore au lieu de simplement s’intensifier. C’est également à ce stade que la direction constate la valeur ajoutée, car l’équipe peut démontrer une réduction des alertes dupliquées, un confinement plus rapide, une responsabilité mieux définie et une diminution des incidents récurrents.
Une matrice de gravité et de SLA que votre équipe peut utiliser
La plupart des équipes de taille moyenne obtiennent de meilleurs résultats avec un modèle de gravité simple qu'avec un modèle trop sophistiqué. La matrice ci-dessous constitue un point de départ pratique que vous pouvez adapter à votre secteur d'activité, aux exigences de votre assurance et à votre modèle de dotation en personnel interne.
| Gravité | Exemple typique | cible de triage initiale | Premier propriétaire | Première action attendue |
|---|---|---|---|---|
| Critical | Compromission confirmée d'identités privilégiées, indicateurs de ransomware sur les systèmes de production, exfiltration de données active, interruption d'activité liée à un incident de sécurité. | 15 minutes | Responsable de la sécurité ou SOC géré | Contenir immédiatement, préserver les preuves, informer la direction |
| Haute | Exécution de logiciel malveillant confirmée, accès impossibles et répétés au compte administrateur, modifications suspectes des contrôles de sécurité, tentative d'exploitation d'une vulnérabilité exposée à Internet avec preuves d'activités ultérieures. | 1 heure | Analyste de sécurité ou responsable informatique senior | Valider le périmètre, isoler l'actif, créer des tâches d'incident |
| Moyenne | Une seule connexion suspecte, une chaîne de processus ponctuelle à risque, un trafic sortant anormal avec des preuves d'impact limitées | de 4 heures | Analyste de niveau 1 ou cogéré | Approfondir le contexte, recueillir des preuves, intensifier les efforts si l'impact s'accroît. |
| Low | Modèle de faux positifs connu, comportement attendu de l'outil, activité bloquée sans indicateurs de persistance | 1 jour ouvrable | Analyste de niveau 1 ou automatisation | Clôture avec code motif, optimisation de la détection si nécessaire |
plats à emporter clés: La gravité des faits doit dicter les délais d'intervention, et non de simples étiquettes sur un tableau de bord.
Standardisez vos procédures de triage avant la prochaine alerte majeure.
MSP Corp peut vous aider à cartographier les sources d'alertes, à définir les règles de gravité, à documenter les procédures d'escalade et à connecter le triage à une surveillance continue (24 h/24 et 7 j/7), à l'automatisation de Microsoft Sentinel et à une réponse gérée. Votre équipe bénéficie ainsi d'un flux de travail reproductible au lieu d'une gestion réactive et précipitée des incidents.
Que faut-il automatiser et que faut-il garder humain ?
L'automatisation est particulièrement précieuse lorsqu'elle élimine les tâches répétitives sans masquer les risques. Les règles d'automatisation de Microsoft Sentinel permettent d'étiqueter, d'attribuer ou de clôturer les incidents, tandis que les playbooks peuvent déclencher des actions correctives plus larges et une orchestration inter-systèmes.91112 Utilisez ce pouvoir de manière sélective.
candidats solides en automatisation
- Suppression et corrélation des doublons
- Enrichissement des entités, recherches et vérifications des renseignements sur les menaces
- Étiquetage, attribution et routage prioritaire des incidents
- Création de tâches pour les contrôles d'analystes standard
- Création de tickets sur les plateformes ITSM
- Notification sur Teams, Slack ou les canaux d'astreinte
- Fermeture à faible risque lorsqu'une règle bénéficie d'une confiance et de preuves solides.
Des décisions qui devraient rester humaines
- Évaluation de l'impact sur l'activité pour les utilisateurs ou systèmes critiques
- Mesures de confinement qui perturbent les opérations ou l'accès des clients
- Questions juridiques, confidentialité, assurances et remontée d'informations par la direction
- Attaques par usurpation d'identité pouvant impliquer les déplacements des utilisateurs, des tiers ou des appareils partagés
- Stratégie de communication avec les clients, les fournisseurs ou la direction
- Clôture définitive des incidents dont la cause profonde n'est pas résolue.
Erreurs courantes de triage qui ralentissent la réponse
Utiliser la gravité de l'outil comme gravité de l'activité
Les étiquettes des fournisseurs sont des informations utiles, mais ne constituent pas des décisions finales. Un niveau de gravité élevé indiqué par un outil peut avoir un faible impact sur l'activité, et inversement.
Carte des actifs critiques absente
Si l'équipe ne parvient pas à identifier les systèmes les plus critiques, la restauration et l'escalade des incidents relèvent de la conjecture. Les recommandations du Cyber Centre et de la CISA insistent toutes deux sur l'importance de cette étape préparatoire.28
Dissocier le triage des plans de traitement
Lorsque le triage ne correspond pas aux actions documentées, le traitement du dossier est bloqué après validation. Conservez des procédures de réponse pour les scénarios courants liés à l'identité, aux terminaux, au réseau et à l'infrastructure.
Ignorer l'exposition sur Internet
L'exploitation des vulnérabilités est en constante augmentation, notamment en ce qui concerne l'accès distant et les infrastructures périphériques. Ces alertes devraient être traitées plus rapidement.5
Fermeture des alertes sans réglage
Chaque faux positif devrait permettre d'améliorer une règle, un seuil ou un processus de suppression. Sinon, la file d'attente se remplira à nouveau du même bruit la semaine prochaine.
En supposant que la reprise puisse attendre
Le confinement sans plan de reprise d'activité est incomplet. Les recommandations relatives aux ransomwares insistent systématiquement sur l'importance, dès le début du processus, de l'ordre de restauration, de l'intégrité des sauvegardes et de la coordination des parties prenantes.78
Comment mettre en œuvre ce flux de travail dans un environnement de marché intermédiaire
Pour la plupart des organisations, la solution la plus rapide n'est pas de créer une équipe SOC interne complète. Il s'agit plutôt de combiner l'implication interne, l'expertise externe et un modèle opérationnel documenté. Cela peut inclure :
- Une couche de détection centrale tels que Services Microsoft Sentinel, afin de normaliser, de corréler et d'automatiser les opérations de sécurité.
- Une fonction de réponse gérée tels que Couverture SOC 24h/24 et 7j/7 via Guardian Shield MDR, afin d'éviter que les alertes critiques n'attendent les heures de bureau.
- Une infrastructure de sécurité commerciale tels que services gérés de cybersécuritéLe triage est donc directement lié à la remédiation, à l'évaluation des risques, au renforcement des systèmes et à la production de rapports.
- Transferts documentés entre les services informatiques, la direction, la conformité et les intervenants tiers.
- Résultats mesurés comme le temps de triage, le taux de faux positifs, le temps de confinement et le volume d'incidents récurrents.
Ce modèle est particulièrement utile pour les PME et les équipes de taille intermédiaire canadiennes où les ransomwares représentent toujours un risque commercial réel et où le niveau de maturité des réponses formelles aux incidents varie selon les secteurs.67
QFP
Qu'est-ce qu'un processus de triage des incidents ?
Le processus de triage des incidents est celui utilisé par votre équipe pour valider les alertes, enrichir le contexte, attribuer un niveau de gravité, désigner un responsable, déclencher le confinement et faire passer les incidents confirmés aux phases d'investigation, de rétablissement et d'analyse des enseignements tirés. Il s'agit du système d'exploitation d'une réponse de sécurité efficace, et non d'un simple rituel de consultation des files d'attente.
Quelle est la différence entre une alerte et un incident ?
Une alerte est un signal émis par un outil de sécurité. Un incident est un événement confirmé ou hautement probable nécessitant une réponse coordonnée. Un bon tri des alertes permet d'éviter qu'elles ne se transforment en incidents, tout en garantissant que les menaces réelles ne restent pas sans réponse.
À quelle vitesse le triage doit-il avoir lieu ?
Les alertes critiques liées aux identités privilégiées, aux systèmes de production, à l'exfiltration de données ou aux indicateurs de ransomware doivent être traitées en quelques minutes, et non en quelques heures. Les incidents à moindre risque peuvent être traités selon un délai plus long, mais ce délai doit être défini au préalable et corrélé à l'impact sur l'activité.
Quelle part du triage devrait être automatisée ?
Automatisez les étapes répétitives et complexes nécessitant l'analyse de données, telles que l'enrichissement, l'étiquetage, la corrélation, la création de tâches et les notifications standard. Conservez l'intervention humaine pour les décisions ayant un impact sur l'activité, les mesures de confinement destructives, les communications avec la direction et les cas ambigus qui soulèvent des questions de sécurité, de confidentialité ou d'opérations.
Quelles équipes devraient être chargées du triage des incidents ?
Dans la plupart des entreprises de taille moyenne, la gestion des incidents est partagée entre le service informatique interne, un responsable de la sécurité ou un RSSI externalisé, et un prestataire SOC ou MDR. L'essentiel est la clarté : une équipe gère la file d'attente, une personne est responsable de l'escalade, et tous connaissent les points de contact.
Par où commencer si notre flux de travail actuel est désorganisé ?
Commencez par cinq éléments fondamentaux : définir la différence entre alerte et incident, cartographier les ressources critiques, créer un modèle de gravité à quatre niveaux, documenter les premières actions de confinement pour les scénarios courants et automatiser la gestion des tickets et des notifications pour les incidents confirmés. Ensuite, affinez le processus en fonction des faux positifs récurrents et des analyses d’incidents réels.
Mettez en place un flux de travail qui permette à votre équipe de passer plus rapidement de l'alerte à l'action.
Si vous avez besoin d'une file d'attente d'incidents plus propre, d'une discipline de réponse plus forte ou d'une meilleure couverture 24h/24 et 7j/7, MSP Corp peut vous aider à définir le flux de travail, à connecter les outils et à opérationnaliser le modèle de réponse en fonction de votre environnement.
Références
- Institut national de la statistique. Le NIST révise la publication spéciale 800-61 : Recommandations et considérations relatives à la réponse aux incidents pour la gestion des risques de cybersécurité.
- Centre canadien de cybersécurité. Élaboration de votre plan de réponse aux incidents (ITSAP.40.003).
- IBM La multiplication des violations de données fait grimper les coûts à des niveaux records..
- IBM Coût d'une violation de données en 2024 : résultats concernant les données multi-environnements et le temps de confinement.
- Verizon. Rapport d'enquêtes sur la violation de données 2025.
- Verizon. Conclusions du rapport DBIR 2025 sur l'impact des ransomwares sur les PME.
- Centre canadien de cybersécurité. Ransomware.
- CISA. Guide #StopRansomware.
- Microsoft Apprendre. Automatisation dans Microsoft Sentinel.
- Microsoft Apprendre. Créer des tâches d'incident dans Microsoft Sentinel à l'aide de règles d'automatisation.
- Microsoft Apprendre. Automatisez la réponse aux menaces grâce aux playbooks dans Microsoft Sentinel.
- Microsoft Apprendre. Déclencheurs et actions pris en charge dans les playbooks Microsoft Sentinel.