Une liste de contrôle pratique pour la mise en œuvre d'une solution MDR destinée aux PME et aux entreprises de taille intermédiaire canadiennes qui ont besoin d'une détection des menaces 24h/24 et 7j/7, d'un tri des alertes plus clair, d'une réponse aux incidents plus rapide et d'une transition plus sûre d'une sécurité réactive à une préparation opérationnelle.

Rendre le MDR opérationnel sans ajouter de bruit supplémentaire.
Si votre équipe est déjà surchargée, la gestion des incidents et des réponses (MDR) ne devrait pas ajouter un tableau de bord supplémentaire à gérer. MSP Corp vous aide à évaluer votre environnement, à prioriser les données de télémétrie pertinentes et à élaborer un modèle de réponse réellement utilisable par votre équipe.
La détection et la réponse gérées ne consistent pas à « activer un outil et croiser les doigts ». Un déploiement MDR efficace intègre les personnes, la télémétrie, les flux de travail, les autorisations, les procédures, les voies d'escalade et les éléments de preuve de récupération au sein d'un modèle opérationnel unique. C'est essentiel, car les plans de réponse aux incidents doivent définir clairement les rôles, les responsabilités, les contacts en cas de crise et les activités de réponse avant même qu'un incident ne survienne.1, 2
Cette liste de contrôle est conçue pour les organisations qui utilisent Microsoft 365, Entra ID, des terminaux, des services cloud, des applications SaaS, le télétravail et un support informatique hybride, externalisé ou interne. Elle est particulièrement utile si vous changez de fournisseur de sécurité, si vous mettez en place une solution MDR pour la première fois ou si vous cherchez à optimiser vos outils de détection existants.
Que signifie « opérationnel » au 30e jour ?
Au terme des 30 jours, le système MDR devrait être capable d'intégrer les données de télémétrie convenues, de classifier et d'escalader les alertes, de contacter les personnes concernées, de mettre en œuvre les actions de confinement approuvées, de documenter les preuves de l'incident et de réaliser au moins un exercice de validation. Cela ne signifie pas que chaque cas particulier est traité de manière optimale. Cela signifie simplement que le système de réponse est opérationnel, évalué et prêt à être amélioré.
Avant la liste de contrôle : ce que MDR doit être capable de faire
La gestion des incidents et des réponses (MDR) doit améliorer la détection et la réponse, et non se limiter à la transmission d'alertes supplémentaires. Le cadre de sécurité informatique NIST CSF 2.0 structure les résultats en matière de cybersécurité autour des axes suivants : gouvernance, identification, protection, détection, réponse et rétablissement. Cette approche est pertinente pour appréhender la préparation à la MDR, car la détection sans réponse ni rétablissement ne constitue qu'un programme incomplet.3
Détecter l'activité appropriée
Votre fournisseur MDR a besoin des données de télémétrie disponibles concernant les terminaux, l'identité, le cloud, la messagerie, les pare-feu et les serveurs critiques. L'objectif n'est pas de tout collecter, mais de fournir suffisamment d'informations pour identifier les activités suspectes, en confirmer la portée et réduire les faux positifs.
Prioriser les risques exploités
Les vulnérabilités identifiées doivent être priorisées en fonction de leur impact sur l'activité et du contexte de la menace. La CISA tient à jour le catalogue des vulnérabilités exploitées connues, qui fait office de source de référence pour les vulnérabilités ayant déjà été exploitées.4
Associer l'activité au comportement de l'attaquant
MITRE ATT&CK est une base de connaissances accessible dans le monde entier sur les tactiques et techniques des adversaires, basée sur des observations du monde réel, ce qui la rend utile pour la logique de détection, la chasse aux menaces et l'analyse post-incident.5
Répondre avec permission
Les mesures de confinement doivent être approuvées avant l'incident. Il convient de définir à l'avance les conditions dans lesquelles l'équipe MDR peut isoler un terminal, désactiver un utilisateur, révoquer des sessions, bloquer une adresse IP, mettre en quarantaine des courriels ou alerter la direction.
Si vous comparez encore les modèles de service, commencez par clarifier ce que MDR, EDR et XDR signifient en pratiqueSi vous savez déjà que le MDR est la prochaine étape appropriée, utilisez le plan de 30 jours suivant.
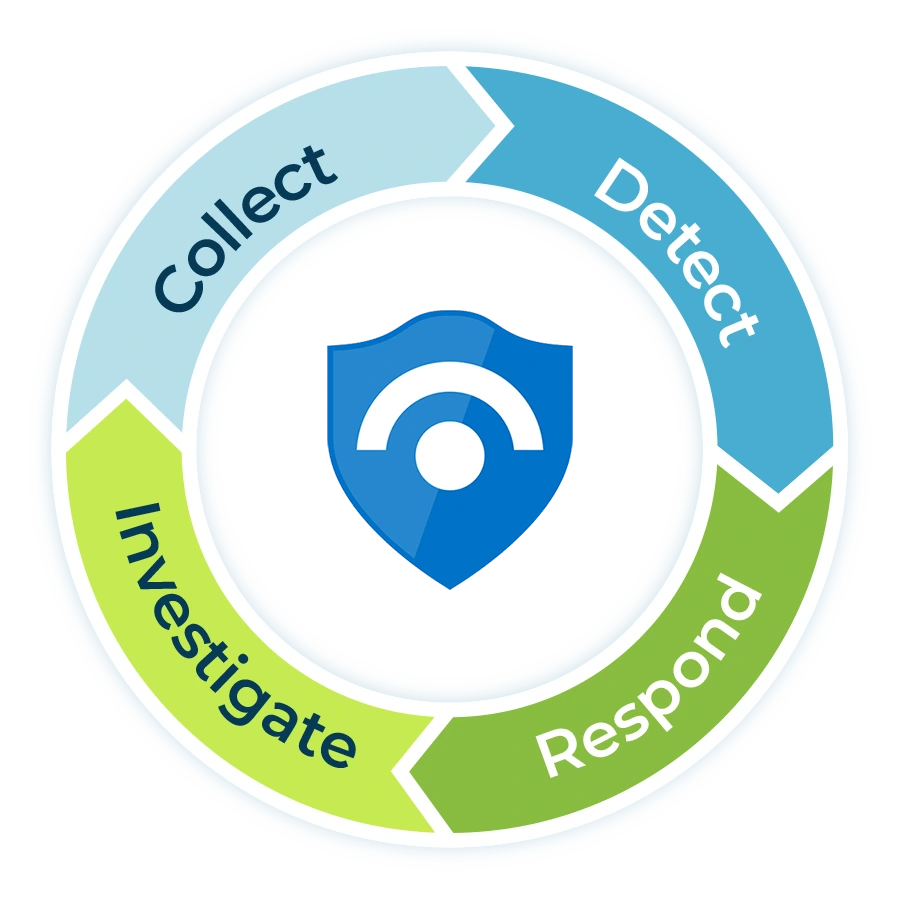
Liste de contrôle de mise en œuvre MDR sur 30 jours
Les déploiements MDR les plus rapides ne sont pas précipités, mais séquentiels. L'ordre ci-dessous garantit un déploiement pratique : confirmer l'autorité de contrôle, connecter les données, tester la réponse, puis optimiser et mesurer.
Avant le premier jour : confirmer l’objectif commercial
Définissez le périmètre avant que les outils, les tickets et les alertes ne soient mis en marche.
- Nommez le propriétaire exécutif. La gestion des incidents liés à la gestion des risques (MDR) nécessite un sponsor métier capable d'approuver les décisions relatives aux risques, les compromis en cas d'interruption de service et les mesures de communication lors d'un incident réel.
- Définissez les trois principaux résultats. Exemples : réduire le temps de présence des attaques de phishing, détecter plus rapidement les compromissions d’identité, améliorer le confinement des ransomwares, étayer les preuves d’assurance cyber ou ajouter une couverture 24h/24 et 7j/7.
- Liste des processus métier protégés. Incluez les systèmes financiers, de paie, de messagerie, d'identité, de gestion des clients, les applications métiers, les partages de fichiers, les sauvegardes et tous les systèmes de stockage de données réglementés.
- Définir le périmètre de mise en œuvre. Commencez par les systèmes les plus importants. Pour de nombreuses PME, cela inclut Microsoft 365, Entra ID, les terminaux, les serveurs, la sécurité de la messagerie, les journaux du pare-feu et les alertes de sauvegarde.
- Définir des indicateurs de réussite. Suivre le volume des alertes, le taux de vrais positifs, le délai moyen de prise en compte, le délai moyen de résolution, la qualité de l'escalade et le nombre de problèmes récurrents éliminés.
Décision à prendre maintenant
Choisissez le périmètre MDR minimal viable pour le 30e jour. Un déploiement ciblé qui protège l'identité, les terminaux, les e-mails et les serveurs critiques est généralement plus précieux qu'un déploiement étendu avec une mauvaise gestion.
Jours 1 à 7 : construire les fondations
Mettez en place les plans d'accès, de contacts, d'autorité et de télémétrie.
- Terminez l'atelier de lancement. Examiner les priorités de l'entreprise, les outils actuels, les lacunes connues, les incidents existants, la capacité informatique interne et les risques liés à la transition vers un nouveau fournisseur.
- Créer l'arborescence des contacts MDR. Inclure les contacts principaux et de secours pour les services informatiques, la direction, la protection de la vie privée, les affaires juridiques, les communications, les finances, les assurances et tous les fournisseurs tiers.
- Fenêtres d'escalade documentaire. Définissez qui peut être contacté en dehors des heures de travail, quels canaux sont autorisés et à quel moment une alerte grave donne lieu à un appel téléphonique plutôt qu'à un courriel.
- Confirmer l'autorité compétente en cas d'urgence. Déterminez quelles actions peuvent être entreprises immédiatement et lesquelles nécessitent une approbation. Il peut s'agir, par exemple, de l'isolation des terminaux, de la désactivation des comptes, de la révocation des sessions, de la suppression des règles de messagerie, du blocage par pare-feu ou du verrouillage des comptes à privilèges.
- Inventaire des identités et des accès privilégiés. Examinez les administrateurs, les comptes d'urgence, les comptes de service, les comptes inactifs, les utilisateurs invités, les boîtes aux lettres partagées et les rôles à haut risque.
- Cartographier les contrôles de sécurité actuels. Inclure l'authentification multifacteur (MFA), l'accès conditionnel, la protection des terminaux, les correctifs, le filtrage des courriels, le filtrage DNS, la couverture de sauvegarde, la journalisation, l'analyse des vulnérabilités et la formation de sensibilisation.
- Choisissez les sources de journaux pour l'intégration. La journalisation et la surveillance aident les organisations à identifier les indicateurs de compromission, à prendre des mesures correctives en temps opportun et à minimiser l'impact des incidents.6
À ce stade, de nombreuses organisations constatent des failles dans leurs contrôles d'identité. Si l'authentification multifacteur (MFA) est activée mais que des attaquants parviennent encore à contourner les règles faibles, il convient de la renforcer. accès conditionnel avant de se fier uniquement aux alertes.
Jours 8 à 14 : connecter la télémétrie et optimiser la réception des alertes
Assurez-vous que l'équipe MDR dispose d'une visibilité suffisante pour prendre les bonnes décisions.
- Télémétrie embarquée des terminaux. Vérifiez la couverture des postes de travail, des ordinateurs portables et des serveurs. Signalez immédiatement les appareils non gérés ou obsolètes.
- Télémétrie d'identité embarquée. Inclure les risques de connexion, les déplacements impossibles, les échecs de l'authentification multifacteur, les modifications privilégiées, les modifications d'accès conditionnel et les activités de session suspectes.
- Courriel embarqué et signaux de collaboration. Surveillez les règles de boîte de réception suspectes, les pièces jointes malveillantes, l'usurpation d'identité, les transferts de masse et les accès inhabituels à SharePoint ou OneDrive.
- Pare-feu intégré, VPN et journaux d'accès à distance. Priorisez les événements qui indiquent une exposition entrante, un accès administratif, des modifications de politique, des connexions à distance et un trafic inhabituel.
- Connectez les alertes cloud et SaaS lorsque cela est possible. Commencez par les systèmes qui contiennent des données sensibles ou qui contrôlent l'accès à d'autres systèmes.
- Connectez les signaux de vulnérabilité et de correctif. Utilisez le contexte de la menace pour prioriser les vulnérabilités connues pour être exploitées, exposées à Internet ou liées à des systèmes critiques.4
- Créer des règles de gravité. Définissez ce qui est considéré comme informationnel, faible, moyen, élevé et critique. Veillez à ce que ces définitions soient suffisamment concrètes pour être comprises par un cadre non spécialiste en sécurité.
- Supprimez soigneusement les bruits parasites. Le paramétrage doit réduire les faux positifs sans masquer les comportements à risque. Consignez chaque règle de suppression et examinez-la au cours du premier mois.
Si les outils Microsoft font partie de l'environnement, vérifiez comment Microsoft Defender XDR et Sentinel s'intègrent au modèle opérationnel. Microsoft Defender XDR inclut des fonctionnalités d'investigation et de réponse automatisées conçues pour aider les équipes de sécurité à gérer plus efficacement un volume important d'alertes.10 Microsoft Sentinel fournit également des playbooks et des connecteurs SOAR qui permettent d'intégrer les flux de travail de réponse dans l'ensemble de l'environnement.11
Jours 15 à 21 : opérationnalisation du triage et de la réponse
Transformer les alertes en décisions reproductibles, en tickets et en actions de confinement.
- Élaborer le flux de travail de triage des alertes. Déterminez comment les alertes sont validées, enrichies, catégorisées, escaladées et clôturées. Une forte… flux de travail de triage des incidents empêche les analystes de traiter chaque alerte de la même manière.
- Élaborer des plans de réponse initiaux. Commencez par le phishing, les suspicions de prise de contrôle de compte, les logiciels malveillants, les indicateurs de ransomware, les activités d'administrateur suspectes, les accès à distance exposés et l'exploitation de vulnérabilités critiques.
- Aligner la collecte des preuves. Définissez les éléments à préserver : horodatages, noms d’utilisateur, noms d’appareils, adresses IP, hachages de fichiers, en-têtes de courriel, règles de boîte aux lettres, arborescences de processus, journaux, captures d’écran et étapes de confinement.
- Définir la propriété du billet. Déterminez quand une alerte MDR crée un ticket, qui le reçoit, quelle priorité lui est attribuée et comment le ticket est clôturé après résolution.
- Confirmer les transferts de responsabilité en matière de correction. Précisez si le nettoyage des appareils, la réinitialisation des comptes, les mises à jour du pare-feu, la purge des e-mails, les correctifs, la restauration des sauvegardes ou les communications avec les utilisateurs sont gérés par le service MDR, le service informatique interne, le MSP ou un fournisseur de logiciels.
- Tester les voies de notification à haut risque. Confirmez que l'équipe MDR peut joindre les bonnes personnes par téléphone ou par un autre canal d'urgence approuvé.
- Examiner les déclencheurs de signalement des violations. En vertu de la LPRPDE, les organisations doivent signaler au commissaire toute atteinte aux mesures de sécurité relatives aux renseignements personnels s’il est raisonnable de croire que cette atteinte crée un risque réel de préjudice important pour une personne.9
Pour une ressource complémentaire plus approfondie, utilisez un plan d'intervention en cas d'incident définir la structure de réponse globale autour de votre processus MDR.
Jours 22 à 30 : validation, optimisation et mise en service
Vérifiez que le processus fonctionne avant de considérer le déploiement comme terminé.
- Organisez un exercice de simulation sur table. Testez un scénario réaliste tel qu'une attaque de phishing entraînant la prise de contrôle d'un compte, des indicateurs de ransomware sur un poste de travail ou une activité d'administrateur suspecte en dehors des heures de travail.
- Simuler une escalade. S'assurer qu'une alerte critique parvienne aux bons contacts, avec suffisamment de contexte pour permettre une prise de décision rapide.
- Valider les actions de confinement. Tester au moins une action de réponse approuvée de manière contrôlée, par exemple en désactivant un compte de test, en isolant un point de terminaison de test ou en bloquant un indicateur de test.
- Lacunes constatées lors des tests. Mettre à jour les coordonnées, les procédures, les chemins d'escalade, les champs des tickets, les définitions de gravité et les sources de données.
- Confirmer la fréquence des rapports. Déterminez ce que le rapport mensuel MDR devra afficher : tendances des alertes, thèmes des incidents, temps de réponse, faiblesses récurrentes, actifs vulnérables et améliorations recommandées.
- Constituez la première liste d'améliorations à effectuer. Les éléments courants comprennent le nettoyage des accès privilégiés, la formation à la lutte contre le phishing, le nettoyage des règles de pare-feu, la réduction du retard dans l'application des correctifs, la validation des sauvegardes, les contrôles BYOD et la liste blanche des applications.
- Maintenez le transfert opérationnel. Confirmer la décision de mise en service au jour 30, les limitations connues, les risques ouverts et les travaux d'amélioration des 60 prochains jours.
La planification en matière de rançongiciels mérite une attention particulière. Le Centre canadien pour la cybersécurité souligne que les rançongiciels demeurent une menace importante pour les organisations canadiennes et qu'ils peuvent perturber directement les services essentiels.8 Il convient donc de tester le MDR face aux comportements de type ransomware, et pas seulement face aux alertes concernant les logiciels malveillants courants.
Liste de contrôle de mise en œuvre du MDR par zone de contrôle
Utilisez ce tableau pour désigner les responsables avant le déploiement. Il permet également aux dirigeants de comprendre pourquoi la solution MDR repose sur bien plus qu'un simple outil de sécurité.
| Zone de contrôle | Que confirmer | Pourquoi cela compte | Prochaine étape interne utile |
|---|---|---|---|
| Identite | Rôles d'administrateur, statut MFA, accès conditionnel, accès invité, connexions à risque, procédure d'urgence. | De nombreux incidents graves commencent par une compromission de compte, une utilisation abusive de jetons, des contrôles d'administration insuffisants ou un accès externe non géré. | Examiner les contrôles Entra et Zero Trust. |
| Endpoints | Couverture des appareils, état de l'agent de sécurité des terminaux, capacité d'isolation, droits d'administrateur local, systèmes non pris en charge. | Le MDR ne peut pas protéger les appareils qu'il ne peut pas voir, et la réponse est ralentie lorsque la propriété du terminal n'est pas claire. | Évaluer l'adéquation de la demande à la liste blanche. |
| Courriel et collaboration | Protection contre le phishing, règles de détection des messages suspects, redirection externe, processus de mise en quarantaine, journalisation des audits de boîtes aux lettres. | Le courrier électronique reste un point d'entrée courant, et les boîtes aux lettres compromises peuvent servir de tremplin à la fraude et aux déplacements latéraux. | Planifiez soigneusement vos simulations d'hameçonnage.. |
| Réseau | Journaux de pare-feu, journaux VPN, règles d'accès à distance, segmentation, chemins d'accès privilégiés, services exposés. | Le contexte réseau permet de confirmer si une activité suspecte est isolée ou fait partie d'une intrusion plus large. | Vérifier les règles du pare-feu. |
| Gestion des vulnérabilités | Couverture du scanner, propriété des correctifs, exceptions aux risques, systèmes exposés à Internet, alignement CISA KEV. | Les vulnérabilités exploitées connues ne doivent pas être traitées comme des éléments ordinaires du backlog.4 | Comparer l'analyse et les tests d'intrusion. |
| Sauvegardes et restauration | Périmètre de sauvegarde, tests de restauration, alertes de sauvegarde, copies immuables, couverture Microsoft 365, responsables de la récupération. | La détection et la récupération de menaces (MDR) peuvent aider à détecter et à contenir les menaces, mais la récupération dépend de sauvegardes fiables et de procédures de récupération éprouvées. | Examiner les responsabilités en matière de sauvegarde M365. |
| Réponse aux incidents | Rôles, niveaux de gravité, arborescence des contacts, gestion des preuves, escalade juridique/de confidentialité, communications. | La rapidité de réaction dépend des décisions prises avant la crise, et non pendant celle-ci.1, 2 | Relier la réponse au plan de continuité. |
Point clé à retenir : le MDR devient utile lorsqu’il est connecté aux systèmes, aux personnes et à l’autorité de réponse nécessaires pour agir.
Que faut-il inclure dans votre dossier de lancement MDR ?
Votre fournisseur MDR ne devrait pas avoir à découvrir votre organisation de A à Z pendant un incident en cours. Préparez un dossier de démarrage suffisamment détaillé pour accélérer le tri et limiter la confusion.
Contexte d'affaires
- Adresses et horaires d'ouverture de l'entreprise
- Systèmes critiques et types de données
- Exigences réglementaires ou d'assurance
- Périodes de coupure connues
- Contacts actuels des fournisseurs et vendeurs
Contexte technique
- Diagrammes de réseau et principales plateformes SaaS
- Architecture d'identité et rôles d'administrateur
- Inventaire des terminaux et des serveurs
- Détails du pare-feu, du VPN et de l'accès à distance
- Outils de sauvegarde et objectifs de récupération
Contexte d'accès
- Liste des comptes privilégiés
- Comptes de service et propriété
- Politiques d'accès conditionnel et d'authentification multifacteur
- procédure d'accès d'urgence
- Règles d'approbation des mesures de confinement
Contexte de réponse
- Plan de réponse aux incidents
- Arbre de contacts et matrice d'escalade
- coordonnées de l'assurance cybernétique
- Règles d'escalade juridique et de confidentialité
- processus d'approbation des communications
Le MDR RACI : qui possède quoi ?
Une erreur fréquente en matière de MDR consiste à supposer que « le fournisseur s'en charge » sans définir ce que cela signifie. Utilisez une matrice RACI simple afin que les équipes internes, le prestataire informatique externe, la direction et les analystes MDR connaissent tous leur rôle.
| Activité | fournisseur MDR | Service informatique interne ou fournisseur de services gérés | Direction | Confidentialité, aspects juridiques ou conformité |
|---|---|---|---|---|
| Surveillance des alertes 24h/24 et 7j/7 | Responsable | Informé | Informé des incidents critiques | Informé lorsque des données réglementées peuvent être impliquées |
| Validation et enrichissement des alertes | Responsable | Consulté pour le contexte du système | Informé de la probabilité d'un impact sur l'activité | Consulté si des données sensibles peuvent être affectées |
| Isolation des points de terminaison | Responsable si pré-autorisé | Responsable de la restauration des appareils | Information sur les perturbations commerciales | Informé si la conservation des preuves est requise |
| Désactivation de l'utilisateur ou révocation de la session | Responsable si pré-autorisé | Responsable de la restauration de l'identité | Conçu pour les cadres supérieurs ou les utilisateurs à fort impact | Consulté lorsque des renseignements personnels peuvent être affectés |
| Correction de correctifs ou de configurations | Consulté | Responsable | Responsable des exceptions liées aux risques | Consulté pour les exceptions de conformité |
| Décision de notification de violation | Fournit des preuves | Fournit un contexte technique | Responsable | Responsable |
| Examen post-incident | Responsable du délai de détection et de réponse | Responsable des mesures correctives | Responsable des décisions relatives aux risques | Consulté pour l'amélioration des rapports et des contrôles |
Pour les organisations qui changent de fournisseur, cette clarté est particulièrement importante. Une transition mal gérée peut entraîner des problèmes d'accès, des alertes manquées, des outils dupliqués ou une imprécision dans l'attribution des tickets. Si votre fournisseur actuel est lent, bruyant ou difficile à changer, utilisez une méthode structurée. liste de contrôle de transition avant de couper.
Exigences relatives aux outils MDR et à la télémétrie
Aucun fournisseur de MDR n'a besoin d'un accès illimité à toutes les données dès le premier jour. Il lui faut cependant les données de télémétrie et les autorisations appropriées pour mener des investigations rapides. CIS Controls v8 met l'accent sur les environnements modernes, notamment les systèmes hybrides et cloud, et propose un ensemble de contrôles pratiques pour améliorer la sécurité informatique.14 Le Centre canadien pour la cybersécurité définit également des contrôles de base pour les petites et moyennes organisations autour d'actions à forte valeur ajoutée qui génèrent une part importante des avantages en matière de sécurité.7
Télémétrie minimale à prioriser
- Identité: Connexions, utilisateurs à risque, modifications de rôles privilégiés, activité MFA, modifications d'accès conditionnel, réinitialisations de mots de passe, activité des jetons et modifications d'accès invité.
- Points de terminaison: Détections de logiciels malveillants, processus suspects, activité PowerShell, indicateurs de persistance, état d'isolation, santé de l'appareil et utilisation des droits d'administrateur local.
- Courriel : Pièces jointes suspectes, clics sur des URL, tentatives d'usurpation d'identité, événements de mise en quarantaine, règles de transfert, règles de boîte de réception et suppressions massives.
- Réseau: Refus de pare-feu, connexions VPN, activité d'administration à distance, trafic sortant inhabituel, événements de filtrage DNS et modifications des services exposés.
- Serveurs et charges de travail cloud : Connexions d'administrateur, modifications de service, journaux d'applications critiques, opérations privilégiées, modifications de fichiers inhabituelles et alertes d'échec de sauvegarde.
- Données sur la vulnérabilité : Actifs exposés sur Internet, vulnérabilités exploitées connues, systèmes non pris en charge, exceptions de correctifs et constats récurrents de risques élevés.
Définir soigneusement les autorisations d'accès
- Accès aux enquêtes en lecture seule pour les journaux, les alertes, les détails des appareils, les événements d'identité et les tableaux de bord de sécurité.
- Accès limité aux réponses pour les actions de confinement approuvées, idéalement en utilisant le principe du moindre privilège et un accès juste à temps.
- Procédure de bris de verre pour les incidents graves lorsque les administrateurs habituels sont indisponibles ou compromis.
- Journalisation des audits pour toutes les actions MDR entreprises dans l'environnement.
- Cadence d'examen de l'accès Ainsi, les autorisations MDR restent à jour même lorsque les outils, les personnes ou les fournisseurs changent.
Évitez le raccourci du « mode dieu ».
La gestion des incidents de sécurité (MDR) nécessite une autorité suffisante pour répondre, mais un accès administrateur étendu présente ses propres risques. Privilégiez le principe du moindre privilège, les comptes nommés lorsque cela est possible, l'authentification multifacteur (MFA), l'accès conditionnel, la journalisation et les audits d'accès périodiques.
Plans de jeu prioritaires pour les 30 premiers jours
N’essayez pas de rédiger tous les scénarios d’intervention avant la mise en production. Commencez par ceux qui présentent le plus de risques pour l’entreprise et la plus forte probabilité d’urgence en dehors des heures ouvrables.
| Playbook | Exemples de déclencheurs | actions de première intervention | Questions du propriétaire |
|---|---|---|---|
| Prise de contrôle de compte suspectée | Voyage impossible, invites MFA inhabituelles, connexion risquée, accès massif aux fichiers, création de règles de boîte aux lettres. | Révoquer les sessions, réinitialiser le mot de passe, désactiver le compte si approuvé, examiner les règles de la boîte aux lettres, vérifier les appareils associés. | Qui peut approuver la désactivation d'un compte de direction en dehors des heures de travail ? |
| Hameçonnage avec interaction utilisateur | L'utilisateur a cliqué sur le lien, une tentative d'authentification a été suspectée, une pièce jointe suspecte a été ouverte, des messages similaires ont été trouvés. | Mettre en quarantaine les messages, bloquer l'expéditeur ou l'URL, réinitialiser les identifiants, vérifier les connexions, notifier les utilisateurs concernés. | Qui envoie les communications aux utilisateurs et quelle langue est pré-approuvée ? |
| Indicateurs de ransomware | Modifications massives de fichiers, comportement de chiffrement, chaîne de processus suspecte, tentative de suppression de sauvegarde, déplacement latéral. | Isoler le terminal, désactiver les comptes compromis, préserver les preuves, vérifier les sauvegardes, escalader par téléphone. | Qui peut autoriser un confinement susceptible d'interrompre les opérations ? |
| Vulnérabilité critique exploitée | Correspondance CISA KEV, tentative d'exploitation exposée sur Internet, VPN ou pare-feu vulnérable, avis d'urgence du fournisseur. | Confirmer l'exposition, appliquer un correctif ou une mesure d'atténuation, bloquer la voie d'exploitation, surveiller les indicateurs, documenter l'exception. | Qui prend le risque si le correctif doit être retardé ? |
| Activité suspecte de l'administrateur | Nouveau rôle privilégié, connexion administrateur inhabituelle, modification de la politique, journalisation désactivée, paramètre MFA modifié. | Valider les modifications, révoquer les sessions suspectes, supprimer les rôles non autorisés, consulter les journaux d'audit. | Qui vérifie si le changement était attendu ? |
| compromission de la charge de travail du serveur ou du cloud | Exécution de commandes suspectes, trafic sortant inhabituel, nouveau service, élévation de privilèges, mise en transit de données. | Recueillir les preuves, isoler si approuvé, identifier les données exposées, examiner les voies d'accès, planifier la restauration. | Qui est responsable des décisions relatives à la disponibilité et au confinement de la charge de travail ? |
Si vous avez besoin d'un point de départ opérationnel plus simple, associez ce flux de travail MDR à une procédure claire. manuel de gestion des incidents pour les pannes de service et une documentation plan de segmentation pour les réseaux qui sont devenus complexes avec le temps.
Tests MDR : comment prouver que le déploiement fonctionne
Les tests doivent être contrôlés, documentés et réalistes. Les recommandations du NIST en matière de réponse aux incidents insistent sur la vérification des incidents, la collecte et l'analyse des données et des preuves, la priorisation des actions de réponse, la limitation des dommages, l'identification des causes profondes et le rétablissement des opérations.2 Votre test MDR devrait démontrer que ces étapes peuvent se produire dans votre environnement.
Effectuez ces quatre tests avant la mise en production.
- Test de contact : Déclencher une fausse alerte de haute gravité et confirmer que l'équipe MDR contacte les bonnes personnes par la voie d'urgence approuvée.
- Test de preuve : Vérifiez que l'alerte contient suffisamment d'éléments de preuve pour que le service informatique et la direction comprennent ce qui s'est passé, ce qui est affecté et ce qui doit être fait ensuite.
- Test de confinement : Utilisez un compte de test sécurisé ou un point de terminaison de test pour valider le flux de travail de confinement et le chemin d'approbation.
- Rapport de test : Produire un exemple de résumé d'incident comprenant la chronologie, la gravité, les actifs affectés, les mesures prises, la cause première, l'impact sur l'activité et les tâches de suivi.
Message de validation utile
Demandez à votre fournisseur de solution MDR : « Montrez-nous précisément ce que notre équipe recevrait à 2 h du matin si une véritable prise de contrôle de compte ou un indicateur de ransomware apparaissait. Qui nous appelle, que disent-ils, quelles preuves obtenons-nous et quelle décision devons-nous prendre ? »
erreurs courantes de mise en œuvre du MDR
La plupart des problèmes liés à la gestion des incidents de sécurité (MDR) ne sont pas dus au concept même de MDR. Ils résultent d'une intégration défaillante, d'une autorité mal définie, d'une télémétrie limitée ou d'une absence de prise en charge des corrections.
Conserver toutes les alertes par défaut
Les alertes par défaut peuvent submerger une petite équipe. Paramétrez-les avec soin, mais conservez une trace des alertes désactivées afin de savoir ce qui n'est plus détecté.
Aucun décideur hors des heures de bureau
La solution MDR est moins utile si le fournisseur détecte une menace la nuit, mais que personne ne peut approuver le confinement avant le matin.
Signalisation manquante du cloud et du SaaS
Les attaques modernes ciblent souvent l'identité, la messagerie, les applications cloud et les fichiers. Les alertes sur les terminaux seules peuvent ne pas prendre en compte le contexte métier.
Aucun propriétaire de dépollution
Une alerte n'est pas résolue tant que sa cause première n'est pas traitée. Déterminez qui se charge des correctifs, du nettoyage, de la reconfiguration, de la restauration, de la formation ou du suivi.
Comment mesurer le succès du MDR après 30 jours
Un bon rapport MDR doit aider les dirigeants à comprendre le risque, et pas seulement l'activité. Le rapport DBIR 2025 de Verizon a analysé plus de 22 000 incidents et plus de 12 000 violations de données confirmées, soulignant ainsi pourquoi les organisations ont besoin de priorités de sécurité fondées sur des preuves plutôt que sur des décomptes d'alertes vagues.12 Le rapport 2025 d'IBM sur le coût d'une violation de données établit également un lien entre une identification et un confinement plus rapides et des coûts moyens de violation plus faibles, renforçant ainsi l'importance de la rapidité de réponse et de la maturité opérationnelle.13
Suivez ces indicateurs mensuellement.
- Couverture: Pourcentage de points de terminaison, de serveurs, d'identités et de systèmes critiques fournissant des données de télémétrie.
- Qualité du signal : vrais positifs, faux positifs, alertes répétées et règles ajustées.
- Vitesse de réponse : temps moyen pour reconnaître, enquêter, faire remonter, contenir et clore.
- Impact sur les entreprises: Incidents évités, temps d'arrêt réduit, comptes compromis contenus, systèmes vulnérables corrigés.
- Amélioration du contrôle : Les causes profondes récurrentes ont été éliminées, telles que les règles d'accès faibles, les services exposés, les lacunes en matière de correctifs ou les sauvegardes manquantes.
- Visibilité exécutive : rapports de tendance clairs, décisions relatives aux risques et prochaines actions approuvées.
Après le premier mois, le programme devrait évoluer de « la solution MDR surveille » à « la solution MDR nous aide à réduire les risques ». Cela signifie que le rapport mensuel devrait inciter à l’action : moins de comptes inactifs, de meilleurs contrôles des e-mails, des règles de pare-feu plus claires, des preuves de sauvegarde plus solides, une couverture des terminaux plus stricte et une meilleure formation des utilisateurs.
Besoin de MDR, mais pas d'un autre outil de gestion ?
MSP Corp aide les organisations canadiennes à passer d'une sécurité réactive à une détection et une réponse efficaces 24 h/24 et 7 j/7. Nous pouvons évaluer vos contrôles actuels, identifier les lacunes en matière d'intégration et concevoir un plan de mise en œuvre sécurisé pour vos utilisateurs, vos systèmes et votre équipe de direction.
Questions à se poser avant de choisir un fournisseur MDR
Le discours commercial importe moins que le modèle opérationnel. Posez des questions qui révèlent comment le fournisseur interviendra lors d'un incident réel.
- De quelles données télémétriques avez-vous besoin durant les 30 premiers jours, et qu'est-ce qui peut attendre ?
- Comment réduire les faux positifs sans masquer les activités suspectes ?
- Quelles actions pouvez-vous entreprendre immédiatement, et lesquelles nécessitent une approbation ?
- À quoi ressemble une alerte critique lorsqu'elle est envoyée à notre équipe ?
- Qui nous appelle en dehors des heures de travail, et que se passe-t-il si le premier contact ne répond pas ?
- Comment gérer simultanément Microsoft 365, Entra ID, les terminaux, les pare-feu et les alertes cloud ?
- Comment documenter les preuves pour un examen de la direction, des assurances, des questions juridiques ou de protection de la vie privée ?
- Comment soutenez-vous la résolution des problèmes, et pas seulement la remontée des alertes ?
- Quelles tactiques et techniques MITRE ATT&CK vos détections couvrent-elles ?
- Comment rendre compte de l'amélioration du programme après les 30 premiers jours ?
Quand le MDR doit-il faire partie d'un plan d'amélioration de la sécurité plus vaste ?
La solution MDR est puissante, mais elle ne remplace pas les contrôles fondamentaux. Si votre environnement comporte des appareils non gérés, des comptes obsolètes, des règles d'accès insuffisantes, des sauvegardes non testées ou des accès distants exposés, la solution MDR doit être mise en œuvre en parallèle d'un plan de remédiation.
Les projets connexes courants comprennent test de pénétration du réseau, Services Microsoft Sentinel, Optimisation de Microsoft 365 Defender, gouvernance et conformité des donnéeset la modernisation de l'accès distant sécurisé, comme par exemple Planification de la migration ZTNA versus VPN.
FAQ sur la mise en œuvre de MDR
La gestion des réponses au litige (MDR) peut-elle être mise en œuvre en 30 jours ?
Oui, le déploiement ciblé d'une solution MDR peut être opérationnel en 30 jours si le périmètre est clairement défini, les données de télémétrie appropriées sont disponibles, les décideurs sont identifiés et les règles de confinement sont approuvées rapidement. La pleine maturité prend plus de temps, mais le 30e jour devrait permettre de mettre en place une surveillance, un triage, une escalade, des procédures d'intervention et un système de reporting fonctionnels.
Par quoi devrions-nous nous connecter en premier ?
Commencez par analyser l'identité, les terminaux, les courriels, les serveurs critiques, l'accès à distance et le contexte des vulnérabilités. Ces sources sont généralement les plus pertinentes pour détecter les compromissions de comptes, les logiciels malveillants, le phishing, les indicateurs de ransomware et les tentatives d'exploitation.
Le MDR remplace-t-il notre équipe informatique interne ?
Non. La solution MDR prend en charge la détection, l'investigation, l'escalade et la réponse. Votre service informatique interne ou votre fournisseur de services gérés (MSP) doit néanmoins assumer de nombreuses tâches de remédiation, telles que l'application de correctifs, les modifications de configuration, la restauration des appareils, la communication avec les utilisateurs, la restauration des sauvegardes et les décisions relatives aux applications métier.
Avons-nous besoin de Microsoft Sentinel ou de Defender pour la gestion des incidents et de la détection des menaces (MDR) ?
Ce n'est pas toujours le cas, mais les outils de sécurité Microsoft peuvent constituer une base solide pour les organisations utilisant Microsoft 365. L'important est de savoir si le fournisseur peut intégrer les outils que vous utilisez déjà et transformer les alertes en actions concrètes.
Quel est le principal risque lié à la mise en œuvre du MDR ?
Le principal risque réside dans l'absence de clarté quant à la responsabilité. Si l'on ignore qui approuve le confinement, qui intervient sur les appareils, qui gère le contrôle de la confidentialité ou qui communique avec les utilisateurs, les alertes MDR peuvent être bloquées lors d'un incident réel.
En quoi le MDR diffère-t-il du support informatique 24h/24 et 7j/7 ?
L'assistance informatique 24h/24 et 7j/7 se concentre sur le support utilisateur et système, tandis que la gestion des incidents (MDR) se concentre sur la détection, l'investigation, l'escalade et la réponse aux menaces. Ces deux services doivent être complémentaires, mais ils sont distincts. Si vous comparez les attentes en matière d'assistance, examinez ce qui est généralement inclus. Assistance informatique 24h/7 et XNUMXj/XNUMX.
Prêt à rendre le MDR opérationnel ?
Une checklist de mise en œuvre MDR n'est utile que si elle se traduit par des actions concrètes. Commencez par définir les objectifs métier : quels risques faut-il réduire ? Qui est habilité à approuver les réponses ? Quels systèmes sont les plus critiques ? Ensuite, connectez les données de télémétrie appropriées, optimisez la réception des alertes, validez les procédures d'escalade et poursuivez l'amélioration après 30 jours.
MSP Corp accompagne les entreprises dans cette transition en toute sécurité. Que vous changiez de fournisseur, intégriez une solution MDR pour la première fois ou cherchiez à optimiser l'utilisation des outils de sécurité Microsoft, notre équipe vous aide à passer d'une gestion rigoureuse des alertes à une réponse opérationnelle efficace.
Commencez par une évaluation claire de votre cybersécurité.
Identifiez vos failles les plus critiques, validez votre niveau de préparation en matière de MDR et obtenez une feuille de route pratique pour la détection et la réponse 24h/24 et 7j/7.
Références
- CISA. « Principes de base du plan de réponse aux incidents. » https://www.cisa.gov/sites/default/files/publications/Incident-Response-Plan-Basics_508c.pdf
- NIST. « SP 800-61 Rév. 3, Recommandations et considérations relatives à la réponse aux incidents pour la gestion des risques de cybersécurité. » https://csrc.nist.gov/pubs/sp/800/61/r3/final
- NIST. « Guide des ressources et présentation du cadre de cybersécurité 2.0 ». https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.1299.pdf
- CISA. « Catalogue des vulnérabilités exploitées connues. » https://www.cisa.gov/known-exploited-vulnerabilities-catalog
- MITRE. « ATT&CK. » https://attack.mitre.org/
- Centre canadien pour la cybersécurité. « Journalisation et surveillance de la sécurité des réseaux. » https://www.cyber.gc.ca/en/guidance/network-security-logging-monitoring-itsap80085
- Centre canadien pour la cybersécurité. « Contrôles de cybersécurité de base pour les petites et moyennes organisations. » https://www.cyber.gc.ca/en/guidance/baseline-cyber-security-controls-small-and-medium-organizations
- Centre canadien de cybersécurité. « Guide pratique des rançongiciels ». https://www.cyber.gc.ca/sites/default/files/itsm00099-ransomware-playbook-e.pdf
- Site Web des lois sur la justice, gouvernement du Canada. « Loi sur la protection des renseignements personnels et les documents électroniques, signalement des atteintes à la protection des données ». https://laws-lois.justice.gc.ca/eng/acts/P-8.6/page-3.html
- Microsoft Learn. « Investigation et réponse automatisées dans Microsoft Defender XDR. » https://learn.microsoft.com/en-us/defender-xdr/m365d-autoir
- Microsoft Learn. « Catalogue de contenu Microsoft Sentinel SOAR. » https://learn.microsoft.com/en-us/azure/sentinel/sentinel-soar-content
- Verizon. « Rapport d'enquête sur les violations de données 2025 ». https://www.verizon.com/business/resources/reports/dbir/
- IBM. « Rapport sur le coût d'une violation de données 2025. » https://www.ibm.com/reports/data-breach
- Centre pour la sécurité Internet. « Contrôles de sécurité critiques CIS v8. » https://www.cisecurity.org/controls/v8