Si votre fournisseur de services gérés (MSP) ne respecte pas les accords de niveau de service (SLA), reste vague sur la sécurité ou vous traite comme un simple numéro de ticket, le véritable risque est de ne pas changer de fournisseur. Le véritable risque est d'attendre la prochaine panne, le prochain audit ou le prochain incident qui vous y contraindra. Utilisez cette liste de contrôle pour une transition sereine et maîtrisée, avec un temps d'arrêt minimal.
Vous ne savez pas s'il est temps de changer ?
Si vous voyez deux ou plus Si vous observez les signaux d'alerte ci-dessous au cours d'un mois type, commencez dès maintenant une analyse du marché des fournisseurs de services gérés (MSP). Si vous constatez UN En cas de signal d'alarme de haute gravité (négligence en matière de sécurité, accès administrateur refusé, pannes répétées), passez directement à la liste de contrôle de transition.
Pour une prochaine étape claire et sans accroc : comparez votre situation actuelle au plan et au périmètre d’intégration d’une société de services gérés (MSP Corp).
Un rapide auto-examen avant de lire les 12 signaux d'alerte
Si vous n'avez que 60 secondes, répondez honnêtement à ces questions. Si vous répondez « non » à deux d'entre elles, vous payez déjà pour le risque.
Votre fournisseur de services gérés (MSP) se porte bien si vous pouvez répondre « oui » à ces questions.
- Visibilité: Je peux voir ce qui est fait chaque mois, pourquoi c'est important et ce que cela a amélioré.
- Contrôle: Nous sommes propriétaires de nos comptes d'administrateur, de notre documentation et de nos licences. Aucun contrôle d'accès.
- Sécurité : Les référentiels de sécurité sont définis, suivis et testés avec nous (et non pas simplement « installés »).
- Cohérence: Les SLA sont respectés et les escalades sont prévisibles.
- Stratégie: Nous avons une feuille de route axée sur les résultats commerciaux, et pas seulement sur la gestion des tickets.
- Départ : Le contrat comprend un plan de sortie clair et un accompagnement lors de la transition.
Pourquoi changer de fournisseur de services gérés est une décision de sécurité, et pas seulement une décision informatique
Les environnements modernes sont un réseau complexe de fournisseurs, de plateformes et de services gérés. Lorsqu'un maillon de cette chaîne d'approvisionnement est défaillant, les répercussions se répercutent sur vous. La CISA inclut explicitement les services gérés dans l'analyse des risques liés à la chaîne d'approvisionnement des TIC ; c'est pourquoi la performance et la transparence des fournisseurs de services gérés (MSP) ont un impact direct sur votre niveau de risque. Guide de gestion des risques liés à la chaîne d'approvisionnement des TIC de la CISA
Le NIST a renforcé cette approche avec ses recommandations relatives à la chaîne d'approvisionnement et ses mises à jour sur la gestion des incidents dans le cadre de la cybersécurité 2.0, qui insistent sur la coordination avec les fournisseurs et les tiers concernés. Si votre fournisseur de services gérés (MSP) ne peut démontrer comment il collabore avec vous lors de la planification, de la réponse et de la reprise après incident, il ne s'agit pas d'un partenariat, mais d'une dépendance non maîtrisée. NIST SP 1305 (Guide de démarrage rapide CSF 2.0 C-SCRM) et NIST SP 800-61 Rév. 3 (Réponse aux incidents)
Les 12 signaux d'alerte : analyse rapide
Chaque signal d'alarme ci-dessous comprend : sa description, son importance, les questions à poser et les prochaines étapes. Commencez par ceux qui correspondent à votre réalité quotidienne.
À quoi s'attendre d'un « bon » fournisseur de services gérés avant de changer ?
Il est plus facile d'évaluer votre fournisseur actuel lorsque vous savez ce qu'est un bon service. À minima, vous devriez constater des engagements de service mesurables (SLA), des rapports clairs et une responsabilité documentée. En gestion des services informatiques, les SLA sont généralement liés à des indicateurs de temps de réponse et de résolution, ainsi qu'à des objectifs de disponibilité. Concepts et meilleures pratiques des SLA
Vous devriez pouvoir demander par écrit les conditions minimales requises.
- La possession: Vos comptes d'administrateur, l'accès locataire, la documentation et les licences.
- Niveaux de service : Objectifs de réponse et de résolution par priorité, plus règles d'escalade.
- Cadence de sécurité : lignes de base + surveillance + tests + amélioration continue (et non pas « installer et oublier »).
- Reporting: Résumé mensuel des services, risques, recommandations et changements intervenus.
- Assistance à la sortie : définir les étapes de transfert, les échéanciers et les livrables.
Les 12 signaux d'alarme (avec les questions à poser et les prochaines étapes à suivre)
Pannes récurrentes et « réparations de fortune »
Si les mêmes systèmes tombent constamment en panne, vous ne bénéficiez pas d'un service de qualité, mais vous devez sans cesse intervenir pour résoudre les incidents. Un fournisseur de services gérés (MSP) performant réduit la récurrence des incidents grâce à l'analyse des causes profondes, la planification du cycle de vie et la gestion des changements.
- Mêmes déconnexions VPN, problèmes d'imprimante, soucis de Wi-Fi, problèmes d'appels Teams.
- Des « redémarrages » fréquents au lieu de solutions durables.
- Les pannes sont expliquées comme « un simple aléa ».
- Les coûts liés aux temps d'arrêt s'accumulent silencieusement.
- Les solutions de contournement deviennent la norme, la sécurité se dégrade.
- Vous perdez confiance dans les technologies de l'information et l'adoption stagne.
- « Montrez-moi vos rapports de gestion des problèmes et d'analyse des causes profondes des 90 derniers jours. »
- « Quels problèmes récurrents seront éliminés le mois prochain, et comment ? »
- « Quelle est votre politique de changement et de correctif pour cet environnement ? »
Non-respect des SLA et escalades imprévisibles
Un retard de réponse est agaçant. Des échéances non respectées à répétition indiquent un problème de livraison. Votre fournisseur de services gérés (MSP) devrait être en mesure de présenter clairement les performances des SLA et les mécanismes d'escalade.
- Les tickets urgents restent en « triage » pendant des heures.
- Aucune clarté concernant les astreintes, aucune définition claire des priorités.
- Des réponses différentes selon les techniciens.
- L'étendue des explosions s'accroît avec le temps.
- La direction perd confiance dans la stratégie informatique.
- Les opérations commerciales deviennent « fragiles ».
- « Quels sont vos objectifs de réponse et de résolution par ordre de priorité ? »
- « Comment fonctionne l’escalade après 30, 60 et 120 minutes ? »
- «Veuillez présenter le rapport SLA du mois dernier et les changements que vous avez apportés en conséquence.»
Vous ne pouvez pas savoir quelle valeur vous obtenez chaque mois
Si un rapport se résume à une liste de tickets ou à un vague résumé, il passe à côté de l'essentiel : les risques ont diminué, les contrôles ont été améliorés, les systèmes ont été stabilisés et les utilisateurs ont été responsabilisés. Un bon rapport est un outil d'aide à la décision.
- Pas de bilan de service mensuel, ou alors il est bâclé et réactif.
- La sécurité est abordée sous l'angle des produits, et non des postures.
- Aucun arriéré clair de « meilleures actions à entreprendre ».
- Le risque augmente avec le temps.
- Le budget devient imprévisible.
- Vous ne pouvez pas justifier les dépenses informatiques auprès de la direction.
- « Affichez les trois derniers rapports ou résumés mensuels. »
- « Quels sont les risques qui augmentent, et que faisons-nous pour y remédier ? »
- « Quels contrôles se sont améliorés d’un mois à l’autre ? »
La sécurité est présentée comme « nous avons installé des outils ».
Les outils ne sont pas synonymes de résultats. Ce qui compte, c'est la couverture, la configuration, la surveillance, la réactivité et l'amélioration continue. Sans données de référence, tests et changements mesurables, vous payez pour une sécurité illusoire.
La gestion des incidents dans le cloud est une réalité de responsabilité partagée, et votre fournisseur de services gérés (MSP) devrait être en mesure d'expliquer qui fait quoi lors de la notification, du triage, de la collecte de preuves, de l'enquête et de la récupération. Conseils de Microsoft en matière de réponse aux incidents pour les environnements cloud
- Aucun document de référence en matière de sécurité.
- Aucun plan de simulation d'hameçonnage ni de déploiement de l'authentification multifacteur.
- Aucun exercice ou test sur table à incident.
- Les erreurs de configuration deviennent des incidents.
- Sans rôles ni procédures établies, la réaction est lente.
- Les audits deviennent coûteux et stressants.
- « Affichez notre configuration de sécurité actuelle et le dernier journal des modifications. »
- « Quels tests avez-vous effectués au cours des 90 derniers jours ? »
- « Qui appelle qui dans les 15 premières minutes d'un incident ? »
L'accès administrateur est refusé ou « géré » de manière à bloquer votre contrôle.
Votre organisation doit toujours être propriétaire de son locataire, des comptes d'administrateur, des mots de passe et de l'accès au registraire de domaine. Si vous devez demander l'autorisation pour consulter votre propre configuration, la transition vers un autre environnement sera difficile.
- Les mots de passe sont stockés exclusivement dans le coffre-fort du fournisseur de services gérés.
- Les licences sont opaques ou regroupées sans clarté.
- La documentation est considérée comme confidentielle.
- Vous ne pouvez pas auditer votre propre risque.
- Les transitions sont plus longues et plus coûteuses.
- Il est plus difficile de contenir les incidents sans accès.
- « Fournir un inventaire des accès administrateur et un plan de transfert des identifiants. »
- « Quels sont les comptes à accès prioritaire et qui les contrôle ? »
- « Où est stockée la documentation actuelle relative au réseau et aux locataires ? »
Frais imprévus, périmètre d'intervention flou ou « tout est en supplément »
La tarification n'a pas besoin d'être bon marché. Elle doit être prévisible et alignée sur les résultats. Un déclencheur fréquent de changement est la hausse des factures alors que la qualité du service reste inchangée.
- Projets facturés sans processus d'approbation clairement définis.
- Facturer des sommes dérisoires pour des tâches administratives de base.
- Packs dont la propriété de la licence est incertaine.
- La planification budgétaire devient impossible.
- Les équipes ont pris du retard et nécessitaient des améliorations.
- La confiance s'érode rapidement.
- « Qu’est-ce qui est inclus et qu’est-ce qui est exclu, sur une seule page ? »
- « Qu’est-ce qui nécessite un énoncé des travaux, et quand ? »
- « Sommes-nous propriétaires des licences et pouvons-nous les emporter avec nous ? »
La documentation est manquante, obsolète ou non partageable.
La documentation n'est pas un luxe, elle garantit la continuité des opérations. Une documentation insuffisante ralentit les transitions et la gestion des incidents devient aléatoire.
- Aucun actif courant en stock.
- Aucun schéma de réseau ni carte d'architecture cloud.
- Aucune liste de fournisseurs, aucun calendrier de renouvellement, ni aucun contact pour les escalades.
- L'intégration d'un nouveau fournisseur devient coûteuse.
- La récupération est plus lente après les incidents.
- Les audits se transforment en opérations de lutte contre les incendies qui mobilisent énormément d'efforts.
- «Veuillez fournir la documentation et les dates de dernière mise à jour.»
- « Où est-il stocké, et qui y a accès ? »
- « Quel est le rythme des mises à jour ? »
Taux de rotation élevé, techniciens inégaux et réexplications constantes
Le changement de prestataire de services gérés (MSP) est souvent motivé par la lassitude. Si chaque ticket nécessite de reprendre le même contexte, vous payez pour des tâches répétitives. Un MSP expérimenté réduit les frictions grâce à une gestion de compte stable, des procédures établies et une chaîne d'escalade claire.
- Différents techniciens proposent des solutions contradictoires.
- Les billets passent d'une équipe à l'autre.
- Votre environnement n'a pas de « propriétaire » unique.
- MTTR augmente (temps de résolution).
- Le risque augmente en cas de changements incohérents.
- Les utilisateurs perdent confiance dans les processus informatiques.
- « Qui est responsable des résultats, et pas seulement des contraventions ? »
- « Quel est votre processus interne de documentation et de transfert de responsabilité ? »
- « Comment éviter que les problèmes ne se reproduisent lors de changements de personnel ? »
L'informatique parallèle et les solutions de contournement mises en place par les employés deviennent la norme.
Lorsque le système informatique devient lent ou imprévisible, les équipes doivent trouver des solutions de contournement. Cela engendre des failles de sécurité, des dépenses inutiles et une prolifération de données qui s'avèrent problématiques lors des audits ou en cas d'incidents.
- Les équipes achètent des applications sans les examiner.
- Les fichiers sont répartis sur des disques personnels, des liens partagés et divers outils.
- Les autorisations sont incohérentes, notamment lors des changements de personnel.
- Davantage de voies d'intrusion et de risques de fuite de données.
- Coûts informatiques plus élevés à long terme.
- Préparation à l'IA plus difficile car les données sont désordonnées et incontrôlées.
- « Affichez notre liste d’applications autorisées et notre processus d’examen. »
- « Comment gérez-vous le cycle de vie des identités et les revues d'accès ? »
- « Quels contrôles de gouvernance des données avons-nous mis en place ? »
Si votre organisation adopte Copilot ou d'autres outils d'IA, la gestion de l'information devient une exigence de sécurité. Pour une liste de contrôle pratique, consultez la ressource de MSP Corp : 10 pratiques de gestion de l'information essentielles au succès de l'IA (PDF)
Des sauvegardes existent, mais les restaurations ne sont pas testées.
Une sauvegarde non testée relève de l'espoir. Votre fournisseur de services gérés (MSP) doit aligner le périmètre de la sauvegarde, les objectifs de RPO/RTO et les tests de restauration sur vos priorités métier.
- Aucun test de restauration documenté.
- On ne sait pas exactement ce qui est protégé (SaaS, terminaux, serveurs, cloud).
- La récupération après une attaque de ransomware se résume à « on trouvera une solution ».
- Les temps d'arrêt coûtent vite cher.
- Les surprises liées à la reprise surviennent toujours au pire moment.
- Les exigences en matière d'assurance et de conformité pourraient ne pas être satisfaites.
- « Présentez les résultats du test de restauration du trimestre précédent. »
- « Quels sont nos objectifs de RPO et de RTO par système ? »
- « Quel est le processus de récupération après une attaque de ransomware ? »
Aucune feuille de route, aucun signal de DSI virtuel, aucune planification du cycle de vie
Si votre fournisseur de services gérés se contente de réagir, vous êtes toujours à la merci d'une perturbation. Un partenaire fiable planifie le cycle de vie du matériel, les améliorations de sécurité, l'optimisation des licences et la croissance.
- Les renouvellements sont des urgences de dernière minute.
- Les projets n'apparaissent qu'après que les choses se soient gâtées.
- Les améliorations en matière de sécurité sont vagues ou non prioritaires.
- Les coûts augmentent de façon imprévisible.
- Le risque s'accumule silencieusement.
- Le système informatique n'est pas aligné sur les objectifs commerciaux.
- « Présentez une feuille de route sur 12 mois et expliquez-en les éléments clés. »
- « Quels sont nos 5 principaux risques et notre plan d’atténuation ? »
- « Quelles sont les actions prévues pour les trois prochains trimestres du cycle de vie ? »
Le processus de départ semble flou, risqué ou « hostile ».
Le meilleur moyen d'évaluer un fournisseur de services gérés (MSP) est de lui demander comment il vous accompagne lors de la transition. Un prestataire professionnel saura vous expliquer comment une transition claire et documentée protège vos opérations et vos données.
- Ils esquivent les questions concernant l'aide à la sortie de crise.
- Ils affirment que la documentation est confidentielle.
- Ils ne peuvent pas fournir rapidement un inventaire des accès.
- La continuité des activités est menacée en période de changement.
- Des failles de sécurité peuvent apparaître lors du transfert de responsabilité.
- Changer de mode de vie devient émotionnellement coûteux.
- « Quelle est votre liste de contrôle standard pour la fin du contrat de travail ? »
- « Comment vous coordonnez-vous avec le nouveau fournisseur de services gérés ? »
- « Quels livrables recevrons-nous, et par date ? »
Liste de vérification pour une transition en douceur : changez de fournisseur de services gérés sans interruption de service.
L'objectif est une transition maîtrisée : aucun blocage inattendu, aucune documentation manquante et aucune interruption de la surveillance. La transition se divise en trois phases : préparation avant la bascule, semaine de transfert et stabilisation.
Ressources utiles de MSP Corp
Phase 1 : Préparation avant le changement (7 à 21 jours)
Veuillez effectuer ces opérations avant d'informer votre fournisseur de services gérés actuel.
-
Confirmer la propriété : domaines, DNS, registraire, locataire Microsoft 365, abonnements cloud, consoles de sauvegarde, outils de point de terminaison, coffres-forts de mots de passe.
-
Constituer un inventaire des accès : Administrateurs globaux, rôles privilégiés, comptes d'urgence, comptes de service, méthodes d'authentification multifacteur.
-
Documentation d'exportation : Schéma du réseau, plages d'adresses IP, configurations pare-feu/VPN, Wi-Fi, inventaire, liste des fournisseurs, garanties, renouvellements.
-
Définir une fenêtre de gel des modifications : Réduire au minimum les changements lors du transfert, sauf s'ils sont critiques.
-
Identifier les systèmes critiques : Paie, ERP, points de vente, applications métier, messagerie, identité, VPN, sauvegardes. Attribution des responsables et évaluation de l'impact des interruptions de service.
Phase 2 : Semaine de transition (du jour 1 au jour 7)
Rendez la passation de pouvoir ennuyeuse
-
Surveillance en double exécution : Le MSP entrant configure la visibilité avant que le MSP sortant ne soit supprimé.
-
plan de rotation des titres de compétences : Faites tourner les identifiants privilégiés dans un ordre contrôlé (ne rompez pas l'automatisation).
-
Système de billetterie et d'escalade : Confirmer qui est d'astreinte, ce qui est considéré comme P1 et comment les utilisateurs contactent l'assistance.
-
Sauvegardes et restaurations : Vérifiez que les sauvegardes sont en cours d'exécution, puis effectuez au moins un test de restauration significatif.
-
Validation de la base de sécurité : Confirmer l'authentification multifacteur, l'accès conditionnel, les politiques de points de terminaison et le routage des alertes.
Phase 3 : Stabilisation (du jour 8 au jour 45)
Là où la plupart des commutateurs réussissent ou échouent
-
Combler les lacunes en matière de documentation : Mise à jour du plan du réseau, de la liste des actifs, de la liste des fournisseurs et du calendrier de renouvellement.
-
Réduire le nombre de tickets récurrents : Identifiez les 3 problèmes récurrents les plus importants et éliminez-les définitivement.
-
Mettre en place des revues mensuelles : risques, changements, performance des SLA, feuille de route, clarté budgétaire.
-
Effectuez une simulation de réponse à l'incident : rôles, arbres de contacts, collecte de preuves et chemins de décision.
Un calendrier de transition pratique (copier-coller)
| Délai | Objectif principal | Non négociables | Le succès ressemble à |
|---|---|---|---|
| Jours -21 à -7 | Préparation | Propriété confirmée, accès à l'inventaire lancé, exportation de la documentation programmée | Vous pouvez prouver la propriété des biens et fournir un inventaire précis au nouveau prestataire de services gérés. |
| Jours -7 à 0 | Préavis contrôlé + planification | Gel des modifications, plan de basculement, contacts d'escalade, calendrier de passation de pouvoir partagé | Tout le monde sait ce qui change, quand, et qui est responsable. |
| Jours 1 à 7 | Remettre | Surveillance en double exécution, routage des alertes validé, test de restauration de sauvegarde effectué | Aucune interruption de visibilité, aucune perturbation majeure pour les utilisateurs |
| Jours 8 à 45 | Stabilisation + améliorations | Documentation mise à jour, réduction des tickets récurrents, renforcement de la sécurité de base | Le nombre de billets diminue, le niveau de sécurité devient mesurable, la direction obtient des rapports. |
Modèle d'e-mail : demander une passation de pouvoir en douceur (sans incident)
Copier et coller
Sujet: Demande de documentation et d'inventaire des accès pour le transfert des services gérés
Salut [nom],
Nous prévoyons une transition vers des services gérés et souhaitons coordonner une transition propre et documentée.
Veuillez fournir, avant le [date], les éléments suivants :
1) Inventaire des accès administrateur (locataire, domaine, abonnements cloud, pare-feu/VPN, systèmes de sauvegarde, outils de point de terminaison)
2) Ensemble de documentations actuelles (schéma de réseau, inventaire des actifs, liste des fournisseurs, calendrier de renouvellement, manuels d'exploitation)
3) Contacts d'escalade et éléments d'incident/problème actifs
4) Proposition d'une réunion de passation de pouvoir avec notre nouveau prestataire de services gérés afin de passer en revue le périmètre et les risques connus
Merci. Notre objectif est d'assurer la continuité de l'entreprise et une transition professionnelle.
Salutations,
[Votre Nom]
Comment comparer les fournisseurs de services gérés lors de votre changement (tableau de bord)
Lors de la sélection, ne vous contentez pas de demander ce qu'ils « offrent ». Demandez-leur ce qu'ils peuvent prouver : respect des SLA, rapports, résultats en matière de sécurité et clarté du processus de départ. Pour des conseils de sélection plus approfondis, consultez : critères de sélection des services pour faire le bon choix.
| Catégories | Ce qu'il faut chercher | Que demander | Réponse du drapeau rouge |
|---|---|---|---|
| Intégration | Plan documenté, accès à l'inventaire, surveillance en double exécution | « Présentez votre liste de vérification d'intégration et votre calendrier type. » | « On verra ça une fois que vous aurez signé. » |
| SLAs | Objectifs de réponse et de résolution par priorité, escalade réelle | « Présentez le rapport SLA du mois dernier et les mesures d’amélioration. » | « Nous ne fournissons pas de rapports, mais nous faisons de notre mieux. » |
| Sécurité | Flux de travail de référence, de test, de surveillance et de réponse | « Comment gérez-vous la réponse aux incidents avec vos clients ? » | « Nous avons installé un antivirus et vous êtes protégé. » |
| Transparence | Évaluations mensuelles, registre des risques, recommandations | « Comment présentez-vous vos rapports mensuels sur les risques et la valeur ? » | « Nous pouvons exporter les billets. » |
| Droit de propriété | Le client possède les droits d'administrateur, la documentation est partagée. | « Aurons-nous un accès administrateur global et un accès d'urgence ? » | « Nous gardons cela pour des raisons de sécurité. » |
| Débarquement | Clause de sortie + livrables de transfert | « Qu’est-ce qu’on y gagne si on part ? » | « C'est une propriété intellectuelle. » |
Ce que MSP Corp fait différemment pendant une transition
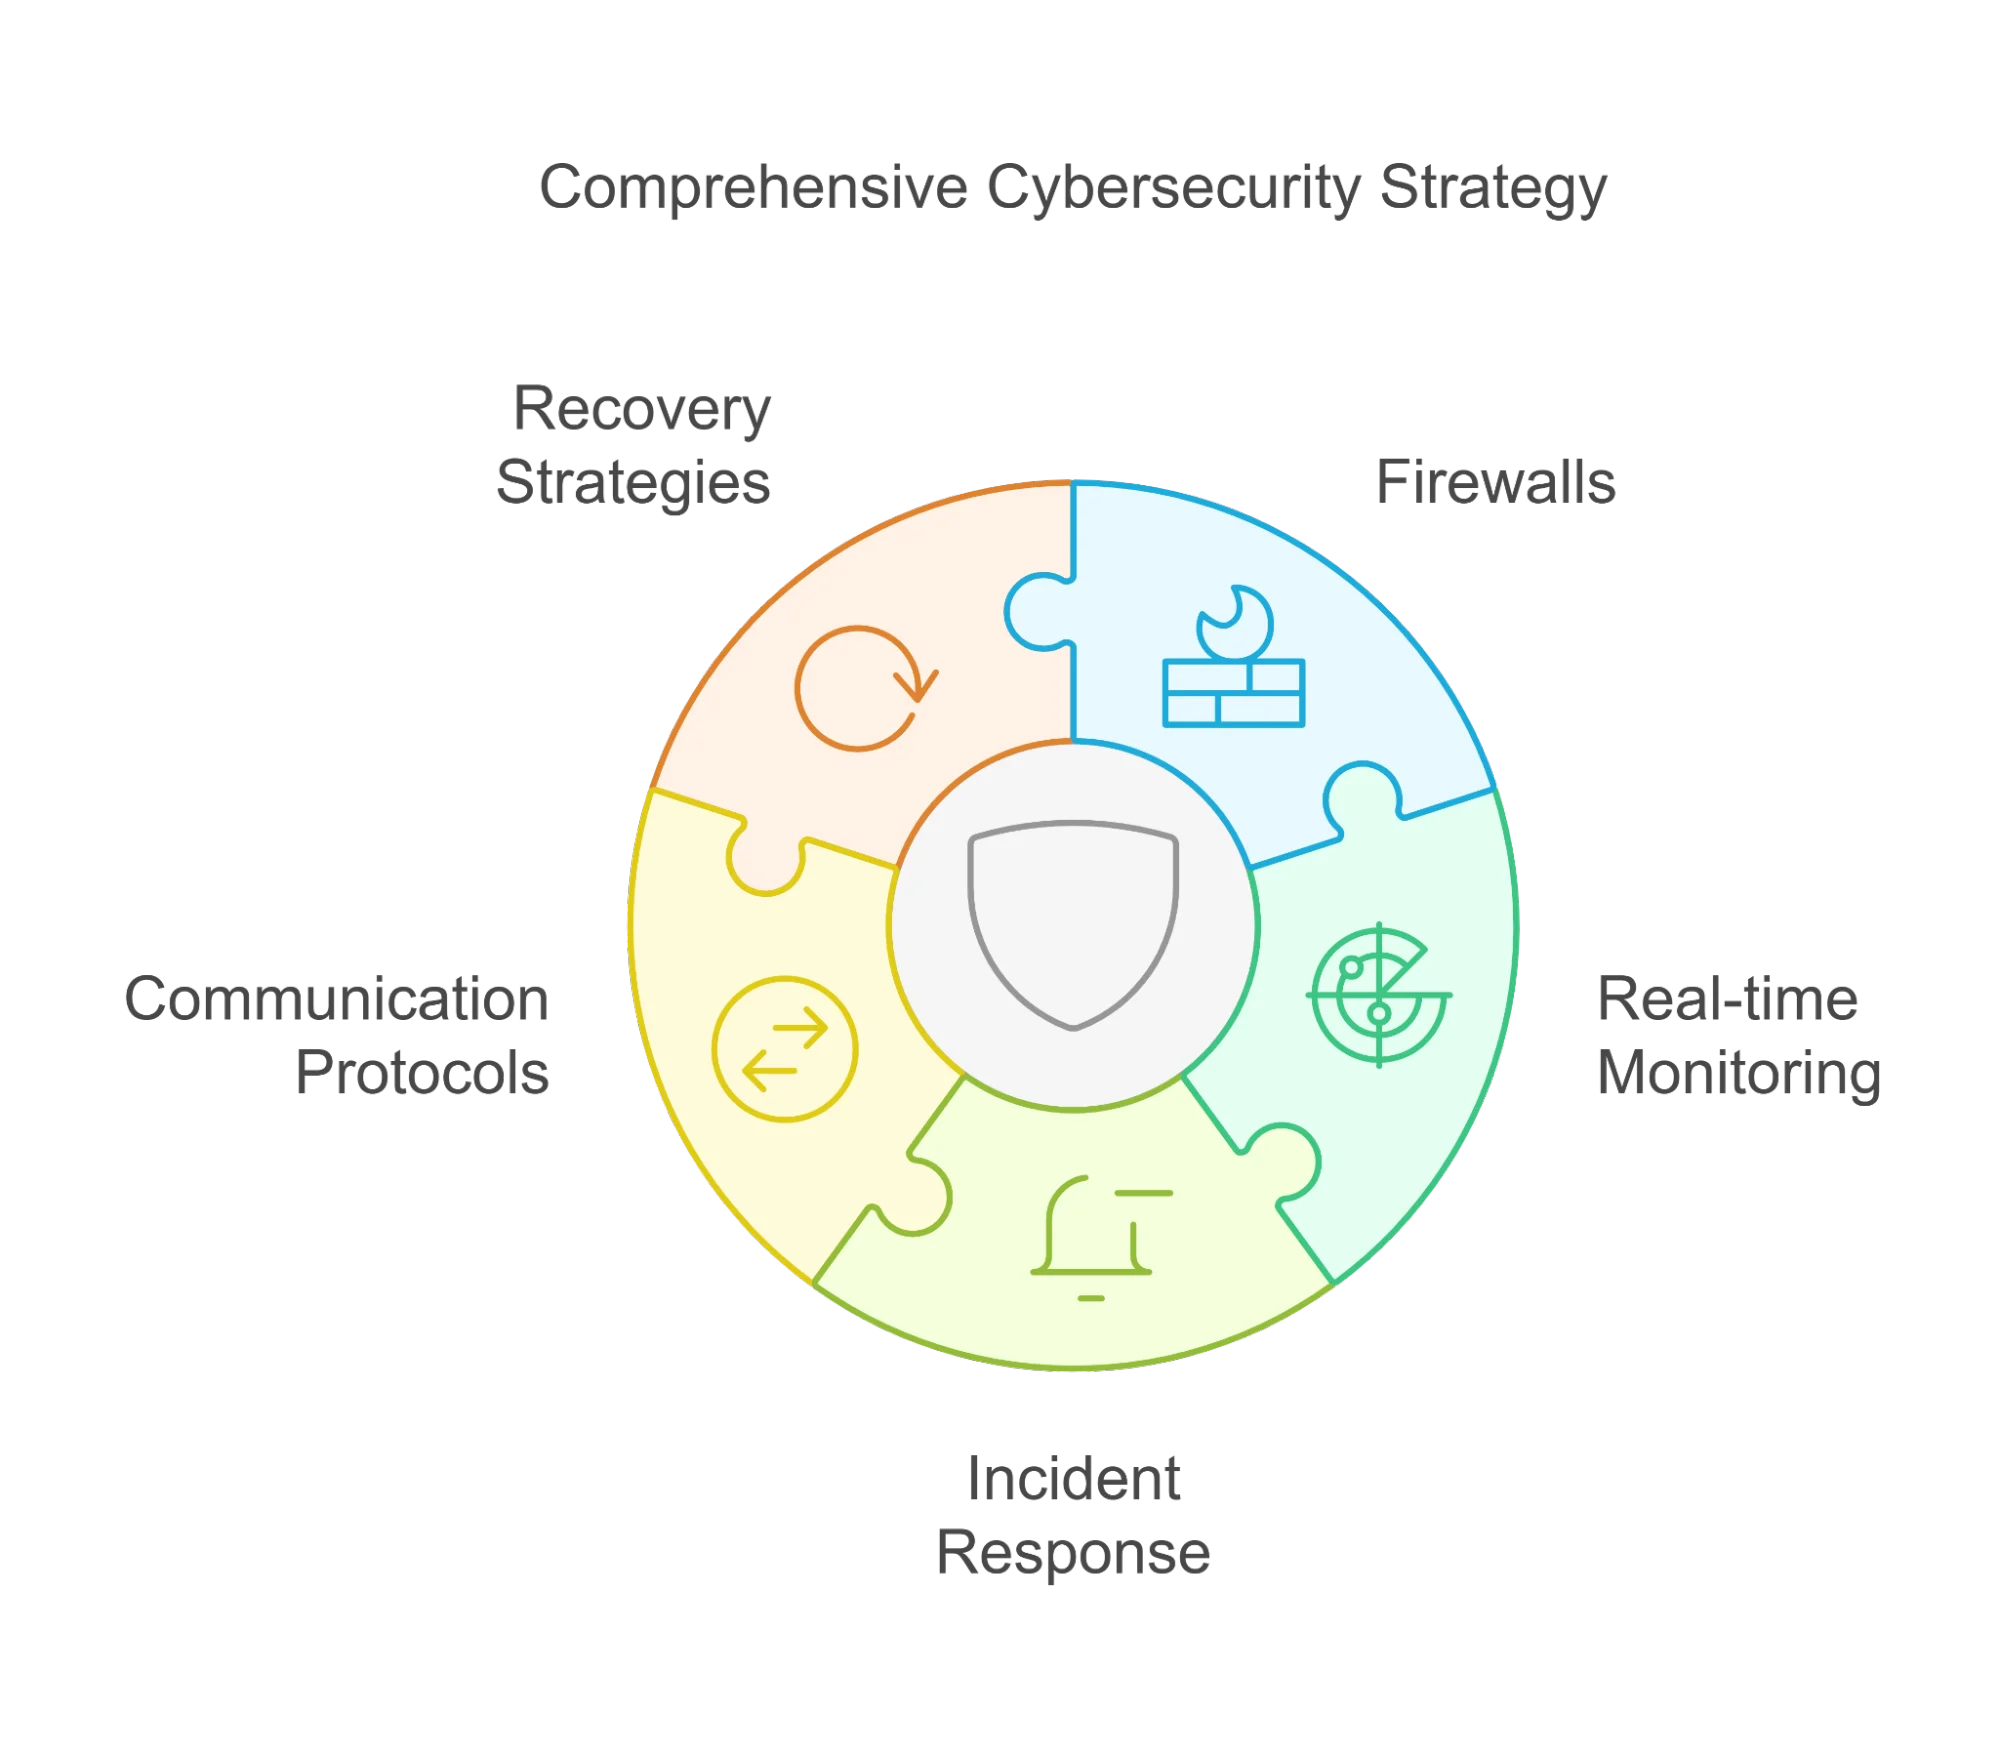
Une transition réussie repose avant tout sur un processus : visibilité d’abord, puis changement maîtrisé, et enfin stabilisation mesurable. Pour une vue d’ensemble complète des services gérés et de leur contenu, consultez : Services informatiques gérés.
Aperçu du processus de transition
- Inventaire de découverte et d'accès : Confirmer la propriété et établir une carte complète des chemins d'administration.
- La visibilité d'abord : surveillance, acheminement des alertes et validation des sauvegardes avant toute suppression.
- Rotation contrôlée des titres de compétences : Les modifications d'accès privilégiés sont effectuées dans un ordre qui ne perturbe pas les systèmes.
- Stabiliser et réduire le bruit : Éliminer les problèmes récurrents et renforcer les normes de sécurité de base.
- Rapports mensuels et feuille de route : Risques, priorités et améliorations mesurables que vous pouvez défendre.
Prêt à changer grâce à un plan contrôlé ?
Si vous souhaitez un plan de transition qui protège la disponibilité, la sécurité et la propriété de la documentation, commencez par définir le périmètre des services gérés et les prochaines étapes.
QFP
Combien de temps faut-il pour changer de fournisseur de services gérés (MSP) ?
Pour la plupart des organisations, une transition maîtrisée s'étend généralement de 2 à 6 semaines, selon la qualité de la documentation, la gestion des accès, le nombre de sites et la complexité des outils. La méthode la plus sûre consiste à privilégier la visibilité, puis à mettre en œuvre des modifications contrôlées, et enfin à stabiliser et optimiser le système.
Mon fournisseur de services gérés actuel peut-il bloquer un transfert de service ?
Si la propriété et l'accès ne sont pas correctement structurés, un fournisseur de services gérés (MSP) peut ralentir le processus. C'est pourquoi les premiers points de la liste de vérification consistent à confirmer la propriété des domaines, des locataires et des rôles d'administrateur. Un bon contrat inclut également une définition claire du support à la sortie et des livrables documentaires.
De quels accès devrions-nous disposer dès le premier jour avec un nouveau fournisseur de services gérés ?
Vous devriez pouvoir accéder aux tableaux de bord d'administration, à la documentation et aux rapports sans restriction. Il est généralement recommandé de conserver des comptes d'accès prioritaire appartenant aux clients et de s'assurer de pouvoir auditer ces accès privilégiés.
Quelle est la principale cause des pannes de commutation ?
Il est déconseillé de procéder à des changements précipités avant d'avoir une visibilité complète. Sans validation préalable de la surveillance, du routage des alertes et des sauvegardes, des failles apparaissent. Planifiez la séquence, bloquez les modifications inutiles et renouvelez les identifiants avec soin.
Devrions-nous opter pour une gestion partagée plutôt que de changer complètement de système ?
La cogestion peut être efficace si les responsabilités sont clairement définies (gestion des identités, des correctifs, de la surveillance de la sécurité et de la réponse aux incidents) et si les rapports sont cohérents. Si les principaux points faibles concernent la transparence et la réactivité, la cogestion peut s'avérer utile. En revanche, si ces points faibles incluent la négligence en matière de sécurité ou le blocage d'accès, une migration complète est généralement préférable.